Revisado em 12/11/2026: esclarecidos os requisitos do cenário VPS–AWS, os custos remanescentes e os limites da expansão.
Cloud bursting é usar capacidade de nuvem pública para complementar uma infraestrutura base quando a demanda aumenta. A carga excedente pode ser atendida por recursos temporários; quando deixa de ser necessária, essa capacidade é retirada. A base pode ser um datacenter privado ou outro ambiente fixo, conforme a arquitetura.
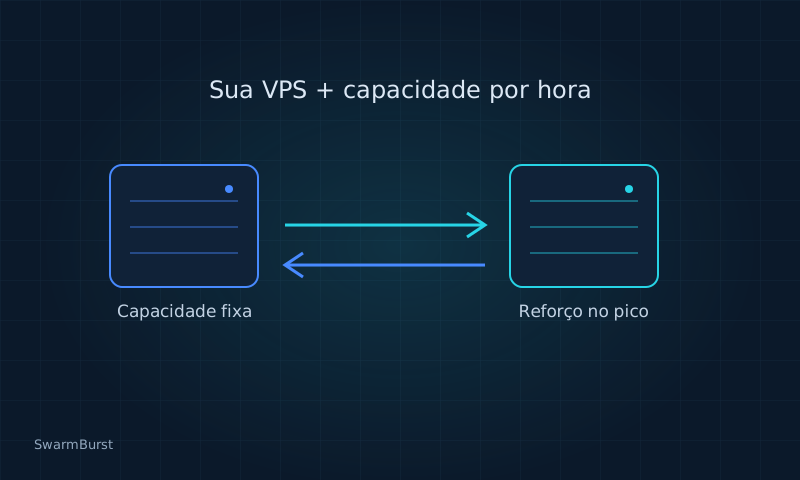
A definição da AWS descreve o uso de recursos de nuvem quando a capacidade local chega ao pico. O padrão de arquitetura do Google Cloud também distingue a carga base da capacidade temporária. Este artigo aplica a ideia ao cenário do SwarmBurst: aplicação em Docker Swarm numa VPS e nós temporários na AWS.
Qual problema o cloud bursting procura resolver?
Uma aplicação pode ter capacidade suficiente nos dias comuns e precisar de mais recursos durante uma campanha. A decisão é comparar otimização, ampliação permanente, expansão temporária e outras arquiteturas que atendam à mesma necessidade.
Não existe economia automática. A comparação precisa incluir tempo de preparação dos nós, instâncias, armazenamento, tráfego, conectividade, implantação e operação. Manter uma VPS e usar AWS no pico pode ser uma opção, mas exige medir a aplicação e cotar os componentes do cenário.
O comparativo de custo completo entre AWS e VPS organiza essa conta sem assumir equivalência de desempenho apenas pela quantidade de vCPU e memória.
Como funciona no cenário VPS com Docker Swarm e AWS
O fluxo abaixo é uma ilustração do mecanismo; não é um resultado de desempenho:
- A VPS atende à operação base. Define-se qual serviço pode ganhar réplicas e onde ficam banco, sessões e arquivos persistentes.
- Uma política observa os sinais de expansão. Ela precisa considerar as métricas suportadas pela ferramenta, a persistência da condição e o tempo para a capacidade ficar útil.
- A capacidade temporária é provisionada. Uma instância EC2 precisa iniciar, receber a configuração e alcançar a rede do cluster.
- O serviço ganha réplicas saudáveis. O nó deve conseguir baixar a imagem, acessar as dependências e atender pelo caminho de entrada previsto.
- A redução é validada. Após a queda da demanda, as réplicas e os nós extras são retirados conforme a política, verificando requisições em andamento e capacidade restante.
- Os recursos da conta são conferidos. Encerrar computação não elimina necessariamente armazenamento ou outros itens cobrados.
O Swarm não redistribui automaticamente todas as tarefas existentes apenas porque um nó entrou, conforme o guia de administração do Docker. Por isso, aumentar máquinas e aumentar réplicas são decisões distintas. O guia de autoscaling em VPS explica o que verificar.
Cloud bursting, autoscaling e CDN são a mesma coisa?
Não. São mecanismos que podem coexistir:
| Abordagem | O que muda | Limite importante |
|---|---|---|
| Cloud bursting | A capacidade base recebe reforço em outro ambiente de nuvem | Requer integração entre ambientes e aplicação compatível |
| Autoscaling | A quantidade de recursos muda por uma política | Não implica necessariamente múltiplos ambientes |
| VPS maior | A base passa a ter mais recursos contratados | Exige comparar custo e capacidade do novo plano |
| CDN e cache | Parte das respostas pode ser atendida antes de chegar à aplicação | Conteúdo personalizado e operações dinâmicas precisam de política específica |
| Migração para nuvem | A aplicação ou seus componentes mudam de ambiente | Não produz escalabilidade por si só; o desenho e a operação continuam necessários |
No e-commerce, é importante separar catálogo público de login, carrinho e checkout. O guia de cache e Cloudflare trata de quais respostas podem ser absorvidas e quais continuam chegando à aplicação.
Quando o cloud bursting merece avaliação?
A hipótese é mais forte quando há picos identificáveis, uma aplicação replicável e capacidade base útil que vale preservar. Um teste precisa mostrar que o serviço escalável ganha capacidade quando recebe recursos e que as dependências suportam a nova concorrência.
Um backend que atende requisições sem depender de estado exclusivo de uma máquina é um candidato mais simples de avaliar. Isso não significa ausência de estado no sistema: banco, sessões e arquivos precisam continuar consistentes e acessíveis.
Antes de contratar capacidade, use o roteiro de teste de carga para comparar latência, erros e utilização de recursos no mesmo intervalo.
Quando adicionar nós não resolve o problema?
- Banco ou integração externa no limite. Mais réplicas podem aumentar conexões e chamadas sem ampliar a dependência. Veja o diagnóstico de MySQL na VPS.
- Sessão ou upload exclusivo do disco local. Uma réplica remota pode não encontrar o dado. Confira o guia de estado em múltiplos servidores.
- Pico mais rápido que a preparação da capacidade. É preciso medir o tempo de criação, rede e inicialização; não existe tempo universal de entrada.
- Demanda alta contínua. Compare uma base maior com o custo total da expansão frequente.
- Aplicação incompatível com o ambiente escolhido. No SwarmBurst, uma instalação sem Docker Swarm exige avaliação e preparação antes do agente. Containers são um requisito deste produto, não uma exigência universal de toda estratégia de cloud bursting.
Se a base mantém a entrada pública ou o banco, ela continua sendo uma dependência. Falha na AWS ou na VPS não vem acompanhada de garantia de que a capacidade restante consiga atender ao pico.
Custos e orçamento: o que precisa ficar explícito
Os controles do agente orientam a operação, mas não são garantia de valor máximo da fatura AWS. Regras de cobrança, recursos externos ao agente, armazenamento e tráfego precisam entrar na conferência.
A AWS documenta cobranças distintas para a instância e recursos associados. Por isso, a etapa final inclui verificar instâncias, volumes e demais recursos usados pela arquitetura, além de conciliar os custos.
Escolha região por conectividade, requisitos e custo total. Proximidade geográfica pode importar, mas é preciso medir o caminho real entre aplicação, banco e usuários; uma região não é automaticamente a melhor para todos os casos.
Onde o SwarmBurst entra
O SwarmBurst é um agente instalado na infraestrutura do cliente para coordenar expansão de Docker Swarm com nós temporários AWS. No cenário atual, a VPS permanece como base e workers remotos recebem réplicas do serviço selecionado. GCP e Azure não são provedores operacionais deste fluxo.
A implantação é assistida e depende de diagnóstico, rede, permissões, imagens e aplicação compatível. Não há cadastro self-service nem promessa de disponibilidade ou economia percentual. O produto está em validação; não apresentamos resultados de clientes como se já existissem.
O checklist de implantação assistida organiza os requisitos e os pontos de aceite.
Perguntas frequentes
Cloud bursting exige migrar toda a aplicação?
Não necessariamente. A proposta é acrescentar capacidade a uma base existente. Ainda assim, preparar rede, estado e implantação distribuída pode exigir mudanças reais na aplicação e na operação.
Quanto tempo leva para adicionar capacidade?
Depende do provisionamento, da imagem, da rede, das dependências e da inicialização. Meça a trajetória até a réplica efetivamente atender; uma instância ligada ainda não comprova capacidade útil.
Cloud bursting garante uma conta menor?
Não. Compare alternativas equivalentes com suas cotações, horas de uso e custos operacionais. O resultado pode favorecer ampliar a base, manter o ambiente atual ou usar outra arquitetura.
Como saber se minha loja é compatível?
Verifique o serviço que precisa crescer, sua forma de implantação, o estado e as dependências. Uma loja instalada diretamente em uma VPS não se torna compatível apenas por instalar o agente.